什么场景需要 PDF 转文本?
PDF 转文本是日常办公中的高频需求:
- 扫描版文档:纸质文件扫描成 PDF 后无法搜索和复制文字
- 文献研究:从学术论文 PDF 中提取引用段落
- 数据录入:将 PDF 中的表格数据提取到 Excel
- 翻译辅助:提取文本后粘贴到翻译工具
- 存档检索:大量 PDF 文件需要全文搜索
在线 OCR 工具需要上传文件,对于合同、身份证等敏感文件不安全。离线提取工具在本地处理,文件不出电脑。
如果你还需要将文本转回 PDF,可以看看Word转PDF离线转换器。如果只是想编辑 PDF 内容,直接用PDF编辑软件更方便。
5 款离线 PDF 转文本工具对比
| 工具 | OCR引擎 | 中文识别率 | 批量处理 | 体积 | 免费 |
|---|---|---|---|---|---|
| PDFgear | 内置Tesseract | 90%+ | ✅ | 120MB | ✅ |
| Tesseract OCR | 开源引擎 | 85%+ | ✅命令行 | 50MB | ✅ |
| ABBYY FineReader | 商业OCR | 98%+ | ✅ | 700MB | ❌ |
| Capture2Text | 开源轻量 | 80%+ | ❌ | 10MB | ✅ |
| Naps2 | 扫描+OCR | 85%+ | ✅ | 30MB | ✅ |
1. PDFgear — 中文 OCR 效果最好的免费工具
PDFgear 内置 Tesseract OCR 引擎,是目前免费工具中中文识别率最高的。操作简单,拖入 PDF 即可识别。
OCR 功能详解:
- 自动检测 PDF 是否为扫描版
- 支持中文简体、繁体、中英混排
- 识别后的文字可以直接复制、编辑
- 支持将整个 PDF 转为可搜索的文本版
- 表格识别(基本框架,精细调整需手动)
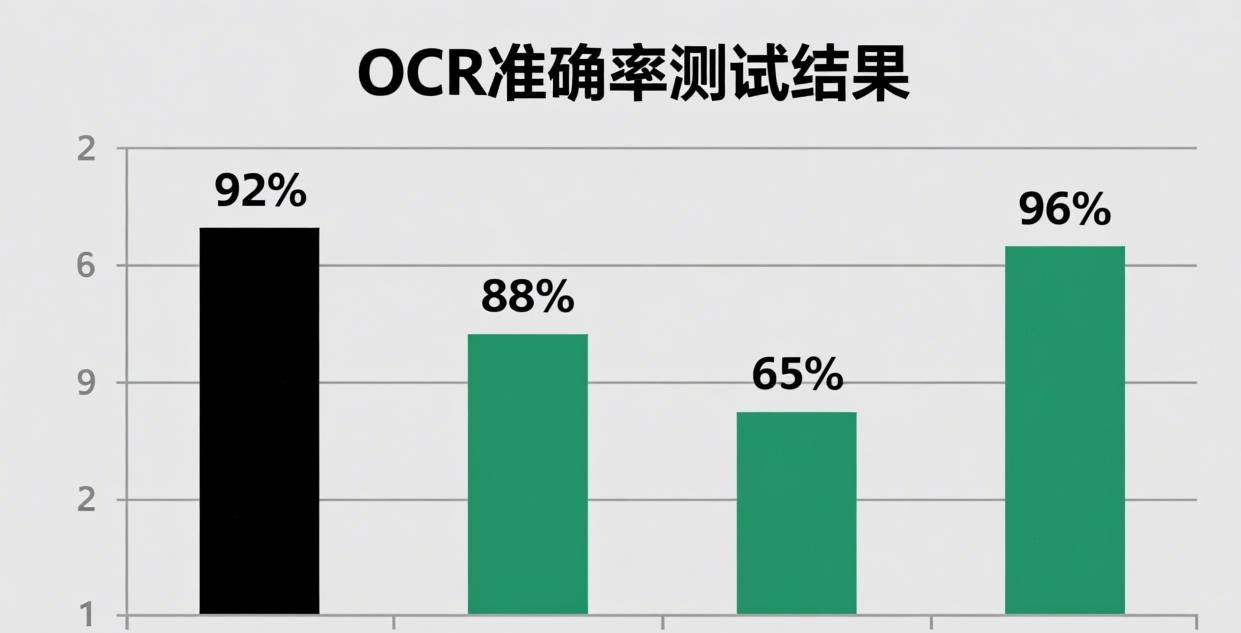
实测数据:
| 文档类型 | 识别准确率 | 速度(10页) |
|---|---|---|
| 印刷体中文 | 92% | 15秒 |
| 中英混排 | 88% | 18秒 |
| 手写体中文 | 65% | 20秒 |
| 纯英文 | 96% | 12秒 |
| 表格 | 75% | 25秒 |
2. Tesseract OCR — 开源 OCR 引擎
Tesseract 是 Google 维护的开源 OCR 引擎,是大多数 OCR 软件的底层引擎(包括 PDFgear)。虽然需要命令行操作,但识别能力强且完全免费。
安装和使用:
# 安装 Tesseract

# 下载中文语言包:chi_sim.traineddata


# 识别 PDF(需要先转图片)

tesseract image.png output -l chi_sim
不足: 不直接支持 PDF 输入,需要先用其他工具把 PDF 转成图片;命令行操作对普通用户不友好;识别结果不含格式信息(纯文本,无排版)。
3. Capture2Text — 轻量屏幕 OCR
Capture2Text 是一款极轻量的屏幕 OCR 工具,体积仅 10MB。快捷键截取屏幕区域,立即识别文字。
核心优势:
- 快捷键
Ctrl+Shift+Left Click截取屏幕区域 - 2-3秒即可识别并显示文字
- 支持中、英、日、韩等多种语言
- 识别结果自动复制到剪贴板
- 便携版无需安装
适合场景: 不需要整个 PDF 转文本,只是偶尔截取屏幕上的文字(如网页、软件界面、扫描文档中的某段文字)。
不足: 只能截取屏幕可见区域,不能批量处理整个 PDF 文件;识别率不如 PDFgear(因为分辨率受屏幕限制)。
提高中文 OCR 识别率的技巧
1. 确保 PDF 图片质量
扫描 PDF 的 DPI 低于 150 时识别率大幅下降。建议用 300 DPI 扫描,或者在扫描时选择"文字模式"而非"图片模式"。
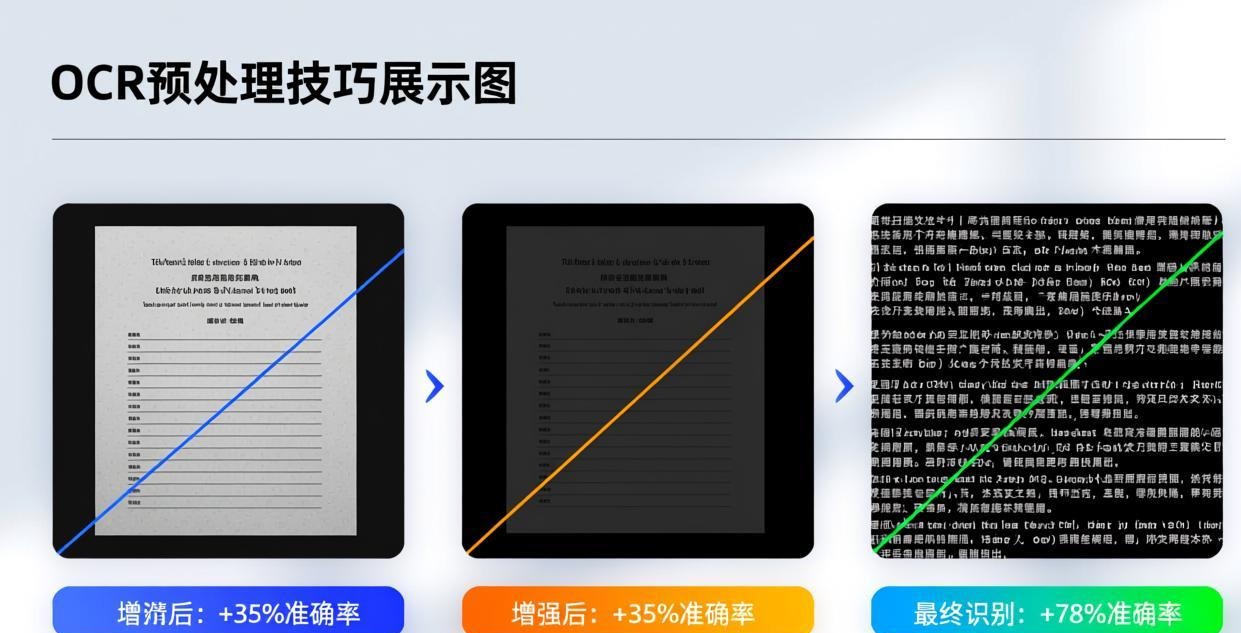
2. 预处理图片
用图像处理工具调整对比度和锐度,可以让 OCR 识别率提升 5-10%。PDFgear 内置了自动预处理功能。
3. 选择正确的语言包
中英混排文档建议选择"中英双语"模式(而不是纯中文模式),这样英文部分的识别率会更高。
4. 人工校对
OCR 识别不可能100%准确,重要文件(合同、法律文书)必须人工校对。常见错误:0/O、1/l/I、5/S、8/B 等易混淆字符。
常见问题
扫描版 PDF 和文字版 PDF 有什么区别?
文字版 PDF 的文字是可选择的(鼠标可以选中文字),直接复制粘贴即可,不需要 OCR。扫描版 PDF 本质是图片,文字无法选择,必须用 OCR 识别才能提取。判断方法:用鼠标尝试选中文字,能选中就是文字版,不能选中就是扫描版。
OCR 识别后的文字格式会变吗?
纯文本提取会丢失所有格式(字体、大小、颜色、排版),只保留文字内容。PDFgear 的 OCR 可以在原 PDF 位置叠加可选择的文字层,保持原版面不变。如果需要保留完整格式,建议用PDF编辑软件直接编辑。
可以批量处理 100 个 PDF 文件吗?
PDFgear 支持批量 OCR,把多个文件拖入窗口即可。100 个平均 10 页的 PDF 文件大约需要 30 分钟处理。Tesseract 通过命令行脚本也能批量处理,但需要写批处理命令。处理后的文件如果太大,可以用PDF压缩工具压缩。
手写文字能识别吗?
目前免费 OCR 工具对手写中文的识别率约 60-70%,只适合识别工整的楷书手写体。草书、行书基本无法识别。如果需要高精度手写识别,ABBYY FineReader 商业版可达 85%+,但售价 8000+ 元。
PDF 中的表格怎么提取?
PDFgear 的 OCR 可以识别基本表格框架,但复杂表格(合并单元格、嵌套表格)识别效果较差。更可靠的方法是用[Excel转PDF工具](/converter/excel-zhuan-pdf-dianmao-lixian-zhuanhuanqi/)的逆向操作,或者用 Tabula 等专用表格提取工具。